La web de una conferencia se construye para que la consulten personas: una agenda que se lee de arriba abajo, fichas de ponentes con foto, un botón grande para comprar la entrada. Pero cada vez más, quien consulta esa web no es una persona, sino un agente que lo hace en su nombre: "¿a qué hora habla Andrey Sitnik?", "¿qué charlas hay sobre IA local?". Y ese agente se encuentra con una interfaz que no se diseñó para él.
Con la web de la [GeeksCAT Conf 2026](https://conf.geeks.cat) (Girona, 26 de septiembre) quisimos probar la alternativa: que la web le diga al agente qué puede consultar y cómo, en lugar de que el agente lo adivine. La agenda incluye charlas como la de Jordi Mas sobre IA local o la de Dario Castañé sobre `AGENTS.md`, así que tenía sentido predicar con el ejemplo y probar WebMCP en nuestra propia web.
El reto: es un sitio 100 % estático, generado con Astro y servido desde GitHub Pages. Sin servidor y sin backend. El código está en [GeeksCAT/conf-2026-web](https://github.com/GeeksCAT/conf-2026-web).
## El problema del _scraping_ del DOM
Hoy, cuando un agente quiere sacar información de una web, tiene tres caminos, y los tres son frágiles:
- **Leer el DOM y deducir la estructura**: qué `h3` es el título de una charla, qué `span` es una hora.
- **Adivinar selectores CSS** que nadie se ha comprometido a mantener. Si un rediseño cambia una clase, el agente gasta más tokens en volver a localizar el elemento o inventa resultados porque, sin ese elemento del DOM, no tiene datos determinísticos de los que partir.
- **Interpretar capturas de pantalla**, que es lento, caro en tokens y la vía más directa a una alucinación: una hora mal interpretada, o un ponente asignado a la charla de al lado.
```js
// ❌ Bad: the agent infers the schedule from markup nobody promised to keep
const talks = [...document.querySelectorAll(".agenda-item")].map(el => ({
time: el.querySelector("time")?.textContent,
title: el.querySelector("h3")?.textContent,
}));
```
```js
// ✅ Good: the agent calls a tool the page registered, with a known schema
get_agenda({ locale: "es" });
// → { conference: "GeeksCAT Conf 2026", locale: "es", schedule: [...] }
```
La web no tiene una forma nativa de decirle a un agente "esta página ofrece estas acciones, con estos parámetros". Tenemos HTML semántico y ARIA para las tecnologías de asistencia, y datos estructurados para los buscadores, pero nada pensado para que un agente llame a una función de la página.
## ¿Qué es WebMCP?
[WebMCP](https://webmachinelearning.github.io/webmcp/) lleva la idea del [Model Context Protocol](https://modelcontextprotocol.io/) al navegador. La página registra herramientas con un nombre, una descripción en lenguaje natural, un JSON Schema para los parámetros y una función que las ejecuta. El agente que trabaja en esa pestaña descubre las herramientas y las llama, en lugar de interpretar la interfaz.
Ya lo usé en [WebPerf Snippets + WebMCP](/posts/webperf-snippets-webmcp), donde las herramientas devuelven código para medir rendimiento. Aquí el caso es más sencillo: no hay nada que ejecutar en la página, solo datos que servir.
La diferencia con un servidor MCP clásico es dónde se ejecutan las herramientas: dentro de la página, con su origen y su sesión, y solo mientras la página está abierta. Si quien navega ha iniciado sesión, la herramienta trabaja con esa sesión; si cierra la pestaña, las herramientas desaparecen con ella.
El estado actual de WebMCP:
- **No es un estándar del W3C.** Es un borrador del [Web Machine Learning Community Group](https://www.w3.org/community/webmachinelearning/), publicado como _Draft Community Group Report_, con editores de Microsoft y Google.
- **La API está en `document.modelContext`.** En las primeras versiones de prueba de Chrome estaba en `navigator.modelContext`, que es la que usé en WebPerf Snippets.
- **Soporte:** Chrome tiene un [_origin trial_](https://developer.chrome.com/blog/ai-webmcp-origin-trial) desde la versión 149 y Edge desde la 150. Firefox y Safari tienen abierta la petición en sus repositorios de _standards positions_. El resumen actualizado está en el [estado de implementación](https://github.com/webmachinelearning/webmcp/blob/main/implementation-status.md) del propio proyecto.
## Arquitectura para un sitio estático
WebMCP asume que hay JavaScript en la página que registra herramientas. En un sitio estático eso no es un problema. Lo que no tenemos es un servidor que responda consultas, así que los datos se generan en el paso de build y la herramienta solo tiene que leerlos.
Lo organizamos en tres capas:
1. **Descubrimiento**: un manifiesto estático en `/.well-known/webmcp.json`.
2. **Datos**: endpoints JSON que Astro genera en build.
3. **Registro**: un script que registra las herramientas con `document.modelContext` cuando la API existe.
### Capa 1: descubrimiento con `/.well-known/webmcp.json`
Con la API de WebMCP, un agente solo descubre las herramientas cuando ya ha cargado la página y ha ejecutado su JavaScript. Para que pueda saber qué ofrece el sitio antes de visitarlo, publicamos un manifiesto en `/.well-known/webmcp.json`, con un alias en `/.well-known/mcp.json`:
```jsonc
{
"name": "GeeksCAT Conf 2026",
"url": "https://conf.geeks.cat",
"version": "1.0.0",
"endpoints": {
"agenda": "/api/agenda.json",
"speakers": "/api/speakers.json",
"event": "/api/event.json"
},
"tools": [
{
"name": "get_agenda",
"description": "Returns the complete conference schedule (sessions, timings, titles, speakers, and abstracts) for GeeksCAT 2026 in Girona.",
"inputSchema": {
"type": "object",
"properties": {
"locale": {
"type": "string",
"enum": ["ca", "en", "es"],
"default": "ca"
}
}
}
}
// get_speakers (optional speaker_slug) and get_conference_info follow the same shape
]
}
```
Tres herramientas, todas de lectura:
- `get_agenda`: la agenda completa, con sesiones, horarios y resúmenes.
- `get_speakers`: ponentes con bio, temática y redes; acepta un `speaker_slug` para pedir uno solo.
- `get_conference_info`: fecha, lugar, entradas y contacto.
**Este manifiesto no forma parte de WebMCP.** El [RFC 8615](https://www.rfc-editor.org/rfc/rfc8615) define el mecanismo de las rutas `/.well-known/`, pero `webmcp.json` no está registrado en IANA ni lo menciona la especificación. Lo mismo pasa con el `` que veremos en la capa 3. El [README del proyecto](https://github.com/webmachinelearning/webmcp#2-static-declarative-manifests) explica que se valoró definir las herramientas solo en manifiestos estáticos y se descartó, porque un manifiesto no puede cambiar según el estado de la página ni contener el código que ejecuta la herramienta. El [explainer sobre service workers](https://github.com/webmachinelearning/webmcp/blob/main/docs/service-workers.md) también menciona un manifiesto de herramientas que podrían indexar crawlers y directorios, y lo considera limitado por la misma razón: es estático.
¿Por qué publicarlo entonces? Porque en nuestro caso esos dos argumentos no nos afectan: la agenda no depende de quién navega ni del estado de la página, y el código que ejecuta la herramienta está en el script de la capa 3. El coste son unos ficheros pequeños. Hoy ningún agente documenta que lo lea, así que lo publicamos por si alguno empieza a hacerlo.
Como tampoco sabemos qué nombre miraría, acabamos publicando el mismo documento en tres rutas, con dos `` en el HTML:
- **`/.well-known/webmcp.json`**, el nombre que lleva el protocolo.
- **`/.well-known/mcp.json`**, que viene del MCP clásico, el de servidores. La propuesta [SEP-1649](https://github.com/modelcontextprotocol/modelcontextprotocol/issues/1649) planteaba publicar ahí una _server card_ para descubrir servidores MCP remotos sin conectarse primero. Esa propuesta está cerrada, la que la continúa ([SEP-2127](https://github.com/modelcontextprotocol/modelcontextprotocol/pull/2127)) usa `/.well-known/ai-catalog.json`, y una _server card_ lleva un campo `transport` obligatorio que nuestro manifiesto no tiene, porque no hay ningún servidor MCP detrás.
- **`/.well-known/webmcp`**, sin extensión, por si algún cliente prueba esa forma.
Los tres ficheros son idénticos byte a byte, y el de sin extensión tiene un "problema": GitHub Pages deduce el tipo de contenido por la extensión, así que lo sirve como `application/octet-stream` en lugar de `application/json`. Un cliente que mire la cabecera lo descartará. Mientras no haya un mecanismo especificado, esto es lo que hay: probar nombres a ver cuál acierta, y asumir que dos de los tres sobran.
Un punto a mejorar: el manifiesto y el script describen las mismas herramientas dos veces, y mantenerlos a mano es la forma más rápida de que dejen de coincidir. De hecho, en nuestra web las descripciones de `get_speakers` y `get_conference_info` ya no son iguales en los dos ficheros, y el manifiesto anuncia `ca` como idioma por defecto mientras el script usa el de la página. Lo razonable es definir las herramientas en un único módulo y generar el manifiesto en build con un endpoint de Astro, que es justo lo que hace la capa 2.
### Capa 2: endpoints JSON generados en build
Astro permite definir [endpoints](https://docs.astro.build/en/guides/endpoints/) en `src/pages/` que devuelven cualquier cosa, no solo HTML. Con `output: 'static'`, cada endpoint se ejecuta una vez durante el build y su respuesta se escribe como fichero: `src/pages/api/agenda.json.ts` acaba siendo `dist/api/agenda.json`. GitHub Pages lo sirve como cualquier otro fichero estático, sin coste de servidor.
Versión simplificada del endpoint de la agenda. La agenda mezcla charlas (`session`) con bloques sin ponente (`spacer`), como las acreditaciones, la pausa del café o la comida, y la versión completa devuelve una estructura distinta para cada tipo:
```ts
// src/pages/api/agenda.json.ts
import { getCollection } from "astro:content";
import type { APIRoute } from "astro";
export const prerender = true;
const locales = ["ca", "en", "es"] as const;
export const GET: APIRoute = async () => {
const talks = await getCollection("talks");
const speakers = await getCollection("speakers");
const result: Record = {};
for (const locale of locales) {
// Speakers indexed by slug, in the same language as the talks
const speakerMap = new Map(
speakers
.filter(s => s.data.locale === locale)
.map(s => [
s.data.slug,
{ name: s.data.name, slug: s.data.slug, role: s.data.role },
])
);
result[locale] = talks
.filter(t => t.data.locale === locale && !t.data.draft)
.sort((a, b) => a.data.time.localeCompare(b.data.time))
.map(t => ({
slug: t.data.slug,
title: t.data.title,
time: t.data.time,
end: t.data.end,
// Only sessions have a speaker; spacers (registration, breaks, lunch) do not
speaker:
t.data.type === "session"
? (speakerMap.get(t.data.speakerSlug) ?? null)
: null,
// The Markdown body of each talk doubles as its abstract
abstract: t.body?.trim() ?? "",
}));
}
return new Response(JSON.stringify(result, null, 2), {
headers: {
"Content-Type": "application/json",
"Cache-Control": "public, max-age=3600",
},
});
};
```
Tres detalles de esta capa:
- **Una sola fuente de verdad.** El endpoint lee las mismas _content collections_ que pintan las páginas de la agenda y de ponentes. Si se corrige el horario de una charla, se corrige a la vez en el HTML y en el JSON; no serán diferentes, justo lo contrario que el manifiesto de la capa 1.
- **Los tres idiomas en un fichero.** `agenda.json` contiene `ca`, `en` y `es` como claves, y la herramienta descarga el fichero entero para quedarse con una. Son 38 KB sin comprimir para una agenda de una sola jornada, así que no compensa complicarlo. En un catálogo grande sería mejor separarlo por idioma (`/api/es/agenda.json`) con `getStaticPaths`.
- **La cabecera `Cache-Control` no llega.** En un build estático, Astro solo escribe el cuerpo de la respuesta; las cabeceras se pierden. Lo que recibe quien pide el JSON es lo que decide GitHub Pages: `cache-control: max-age=600`, igual para todos los ficheros. Si necesitamos otra política de caché, se configura en el hosting, no en el endpoint.
### Capa 3: registro en el navegador
En `BaseLayout.astro` añadimos el enlace al manifiesto y el script que registra las herramientas:
```astro
```
`is:inline` hace que Astro no procese ni empaquete el script: se sirve tal cual desde `public/scripts/`. Con `defer` no bloquea el renderizado.
En WebPerf Snippets cargaba el registro con un `import()` dinámico solo si la API existía, para no añadir ningún coste en los navegadores sin soporte. Aquí el script se carga siempre, y es intencionado: pesa poco y, como veremos en la sección de testing, `window.__webmcpTools` sirve para probar las herramientas desde cualquier navegador.
El script, con `get_agenda` como ejemplo:
```js
// public/scripts/webmcp.js
(() => {
async function fetchJson(url) {
try {
const res = await fetch(url);
if (!res.ok) throw new Error(`HTTP ${res.status}`);
return await res.json();
} catch (err) {
console.warn("[WebMCP] Failed to fetch data:", url, err);
return null;
}
}
const tools = {
get_agenda: {
name: "get_agenda",
description:
"Returns the complete conference schedule (sessions, timings, titles, speakers, and abstracts) for GeeksCAT 2026 in Girona.",
inputSchema: {
type: "object",
properties: {
locale: { type: "string", enum: ["ca", "en", "es"] },
},
},
execute: async params => {
// Fall back to the page language when the agent does not ask for one
const lang = params?.locale || document.documentElement.lang || "ca";
const data = await fetchJson("/api/agenda.json");
if (!data) return { error: "Unable to retrieve agenda" };
return {
conference: "GeeksCAT Conf 2026",
locale: lang,
schedule: data[lang] || data.ca || [],
};
},
},
// get_speakers and get_conference_info follow the same pattern
};
// Plain object on window: lets anyone call execute() from the DevTools console
window.__webmcpTools = tools;
// document.modelContext is where the spec places the API;
// navigator.modelContext is where early Chrome builds exposed it;
// window.modelContext is where some polyfills and inspectors leave it
function registerTools() {
const ctx =
document.modelContext || navigator.modelContext || window.modelContext;
if (!ctx || typeof ctx.registerTool !== "function") return false;
for (const tool of Object.values(tools)) {
const res = ctx.registerTool({
name: tool.name,
description: tool.description,
inputSchema: tool.inputSchema,
execute: tool.execute,
});
// registerTool() returns a promise, so a failure arrives as a rejection
res?.catch(err =>
console.warn(`[WebMCP] Failed to register tool "${tool.name}":`, err)
);
}
console.info("[WebMCP] Registered tools for GeeksCAT 2026");
return true;
}
// The script is deferred, so the API may not be there on the first attempt
if (!registerTools()) {
addEventListener("DOMContentLoaded", registerTools, { once: true });
addEventListener("load", registerTools, { once: true });
}
})();
```
Lo que merece la pena comentar:
- **Tres ubicaciones para la misma API.** La especificación la sitúa en `document.modelContext`. Las primeras versiones de Chrome la expusieron en `navigator.modelContext`, y `window.modelContext` es donde la dejan algunos polyfills e inspectores. El script prueba las tres en ese orden. En Chrome Canary con el flag activado, `typeof document.modelContext` devuelve `"object"`, así que las otras dos opciones no se ejecutan: están por si acaso.
- **Un reintento, porque el script es `defer`.** Se ejecuta antes de `DOMContentLoaded`, y si en ese momento no hay API, se vuelve a intentar en `DOMContentLoaded` y en `load`. Sin ese reintento, una API que aparezca más tarde se queda sin herramientas registradas.
- **`registerTool()` devuelve una promesa.** Un fallo al registrar llega como rechazo, no como excepción, así que cada llamada lleva su `.catch()`. El mensaje de éxito, en cambio, se escribe sin esperar a las promesas: puede aparecer aunque un registro falle un instante después. Es lo que hay que afinar de esta capa.
- **Sin `annotations` todavía.** La especificación define anotaciones como `readOnlyHint`, que le dicen al agente que llamar a la herramienta no modifica nada. Las tres solo leen datos públicos, así que encajan, pero el script no las envía.
- **`execute()` lee, no calcula.** Toda la lógica es un `fetch` a un JSON que ya existe y un filtro por idioma. Si falla la red, la herramienta devuelve un `{ error }` en lugar de lanzar una excepción, y el agente recibe una respuesta que puede interpretar.
> Un aviso sobre `window.__webmcpTools`: exponer las herramientas en `window` significa que cualquier script de la página puede llamarlas. Aquí no es un problema, porque solo leen datos públicos. Con herramientas que cambian estado, como comprar una entrada o enviar un formulario, no deberían quedar en `window`.
## Probarlo en Chrome DevTools
Hay dos niveles de prueba, según lo que queramos comprobar.
### La lógica de las herramientas, en cualquier navegador
`window.__webmcpTools` existe tenga o no el navegador soporte para WebMCP. Si abrimos [conf.geeks.cat](https://conf.geeks.cat) y la consola de DevTools, podemos llamar a `execute()` directamente:
```js
// Full schedule in Spanish
await window.__webmcpTools.get_agenda.execute({ locale: "es" });
// A single speaker
await window.__webmcpTools.get_speakers.execute({
locale: "es",
speaker_slug: "andrey-sitnik",
});
// Date, venue, tickets and contact
await window.__webmcpTools.get_conference_info.execute();
```
Las llamadas de la captura están hechas sobre la página en catalán y sin pasar `locale`, por eso devuelven `ca`: sin ese parámetro, la herramienta usa el idioma de la página.
Es exactamente la función que llamaría el agente, de modo que sirve para probar el `fetch`, el idioma por defecto y los errores. Lo que no prueba es el registro.
### El registro, con WebMCP activado
Para probar el registro necesitamos un navegador que implemente la API:
1. Activar `chrome://flags/#enable-webmcp-testing` y reiniciar Chrome.
2. Recargar la página y comprobar en consola que `document.modelContext` existe y que el script confirma el registro con un mensaje `[WebMCP]`.
3. Abrir el panel **Application > WebMCP** de las DevTools, que lista las herramientas registradas, permite invocarlas a mano y enseña lo que devuelven. La extensión [Model Context Tool Inspector](https://chromewebstore.google.com/detail/model-context-tool-inspec/gbpdfapgefenggkahomfgkhfehlcenpd) hace lo mismo en los navegadores donde ese panel todavía no está.
Así se ve el panel con las tres herramientas registradas y una llamada a `get_agenda` ya completada:
La [documentación de Chrome sobre WebMCP](https://developer.chrome.com/docs/ai/webmcp) explica este flujo de desarrollo local con más detalle.
Y para la capa 1, basta con pedir el manifiesto:
```bash
curl -sI https://conf.geeks.cat/.well-known/webmcp.json
```
GitHub Pages lo sirve con `content-type: application/json` y `access-control-allow-origin: *`, así que un agente puede leerlo desde cualquier origen.
## Conclusión
Para un sitio estático, WebMCP cuesta poco: datos que ya teníamos, generados en build desde el mismo contenido que pinta las páginas, y un script de poco más de cien líneas. En los navegadores sin soporte, ese script solo deja las herramientas en `window.__webmcpTools`.
La API está en _origin trial_ y el manifiesto de `/.well-known/` es una convención nuestra, no parte de la especificación. Además, para una web de solo lectura como la de una conferencia, la diferencia con publicar datos estructurados es menor de lo que parece. Donde WebMCP aporta de verdad es en acciones con parámetros y con la sesión de quien navega: filtrar la agenda por temática, reservar plaza en un taller, comprar la entrada.
La pieza que falta es el descubrimiento antes de visitar la página. Mientras no se especifique, cada sitio se inventará su manifiesto, como hemos hecho nosotros. Si os interesa ver cómo evoluciona, [conf.geeks.cat](https://conf.geeks.cat) está en producción, y si venís a Girona el 26 de septiembre, lo comentamos en persona.
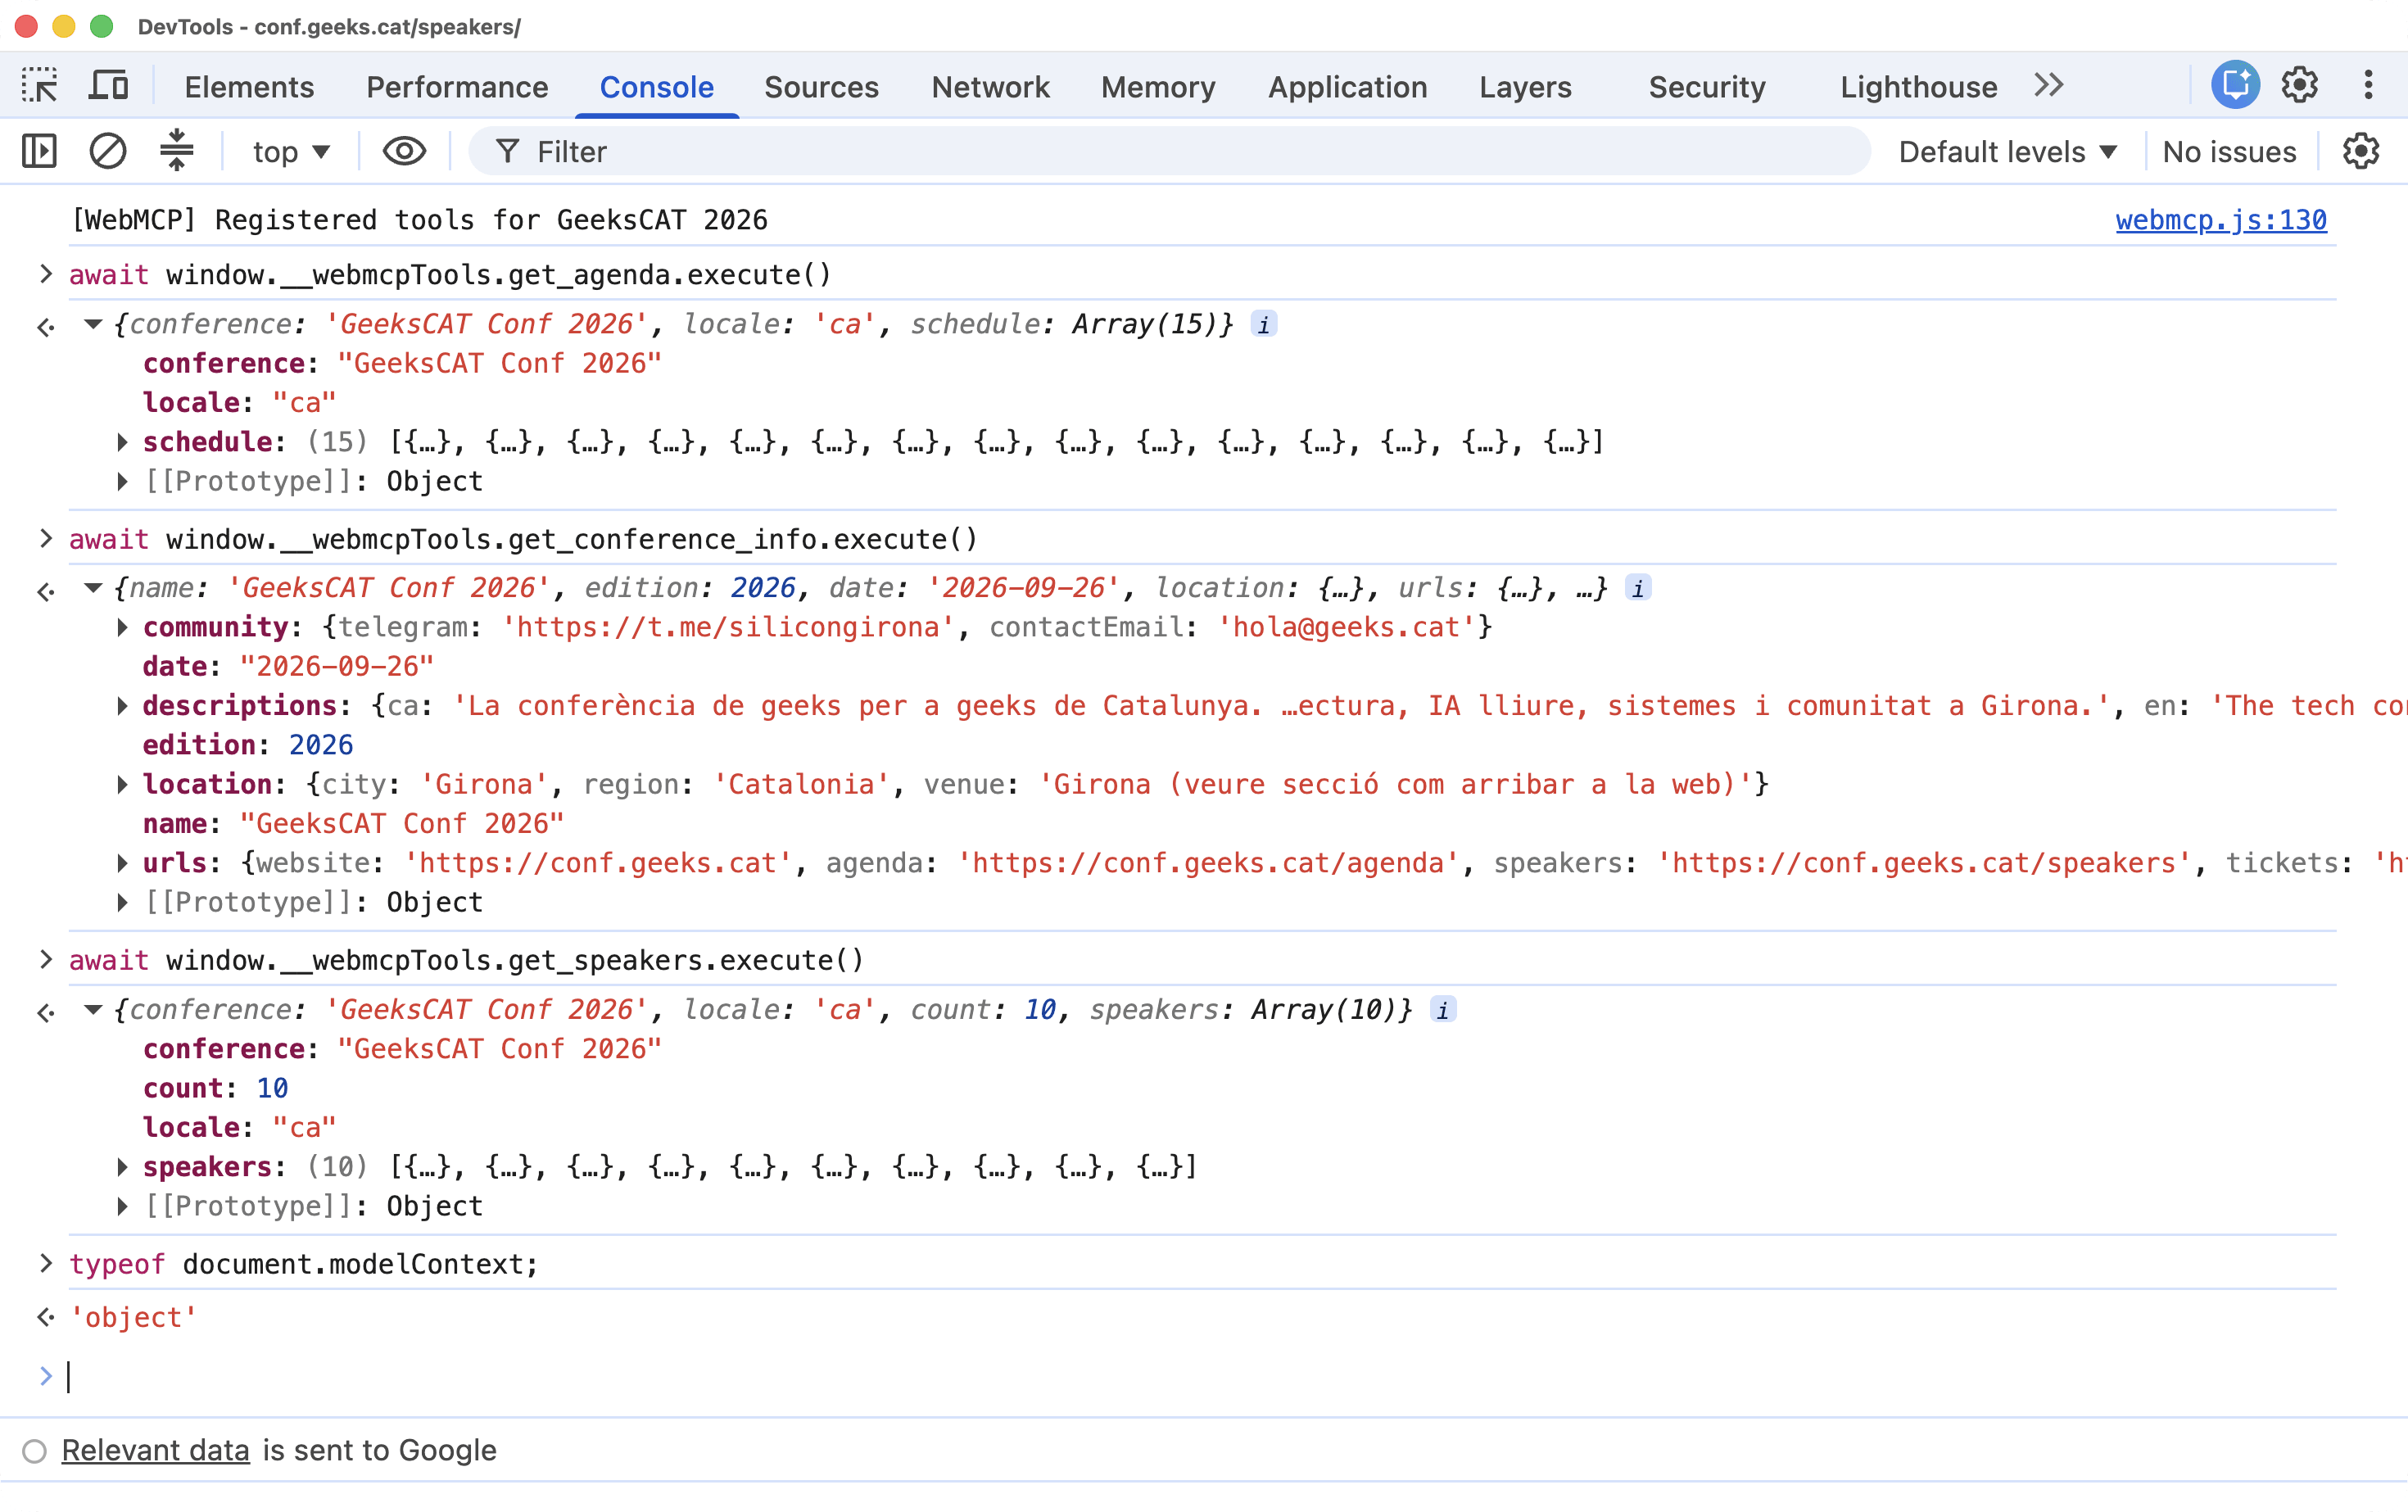 Las llamadas de la captura están hechas sobre la página en catalán y sin pasar `locale`, por eso devuelven `ca`: sin ese parámetro, la herramienta usa el idioma de la página.
Es exactamente la función que llamaría el agente, de modo que sirve para probar el `fetch`, el idioma por defecto y los errores. Lo que no prueba es el registro.
### El registro, con WebMCP activado
Para probar el registro necesitamos un navegador que implemente la API:
1. Activar `chrome://flags/#enable-webmcp-testing` y reiniciar Chrome.
2. Recargar la página y comprobar en consola que `document.modelContext` existe y que el script confirma el registro con un mensaje `[WebMCP]`.
3. Abrir el panel **Application > WebMCP** de las DevTools, que lista las herramientas registradas, permite invocarlas a mano y enseña lo que devuelven. La extensión [Model Context Tool Inspector](https://chromewebstore.google.com/detail/model-context-tool-inspec/gbpdfapgefenggkahomfgkhfehlcenpd) hace lo mismo en los navegadores donde ese panel todavía no está.
Así se ve el panel con las tres herramientas registradas y una llamada a `get_agenda` ya completada:
